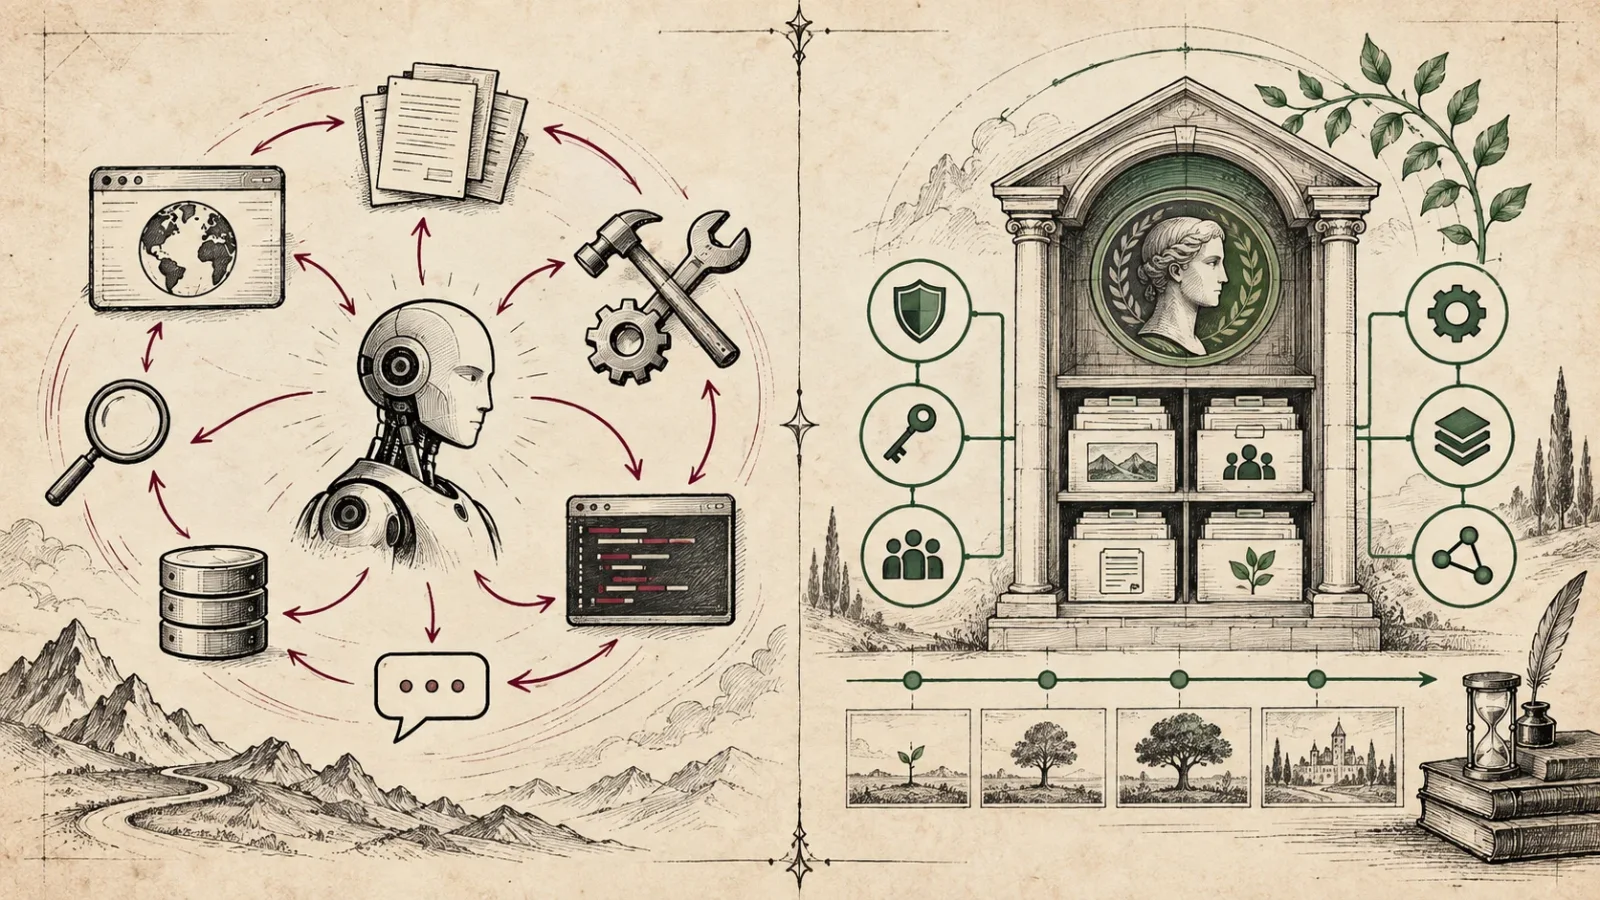
V posledních měsících se debata o umělé inteligenci stále častěji točí kolem agentů. Systém otevře prohlížeč, vyhledá informace, upraví soubor, zavolá API, napíše e-mail nebo dokončí několik navazujících kroků bez dalšího pokynu člověka.
Na první pohled to vypadá jako přirozený přechod od chatbotu ke skutečné digitální inteligenci. Možná ale v tomto obrazu zaměňujeme několik různých vrstev:
- LLM je jazykový a asociační model,
- agent je mechanismus, který model zapojuje do opakovaného řešení úkolu,
- Self je návrhový koncept širšího, dlouhodobě existujícího digitálního systému.
Výchozí myšlenka tohoto článku je proto širší než bezpečnější agentní framework:
LLM není mozek. Agent není inteligence. Self není jen harness kolem LLM. Self je pokus skládat kompletní digitální inteligentní systém z více specializovaných částí.
Slovo Self zde používám jako architektonický a filozofický koncept. Neříká, že takový systém má vědomí, subjektivní prožívání nebo lidskou osobnost. Říká pouze, že systém může mít identitu, paměť, historii, zkušenost, schopnosti a kontinuitu, které nejsou totožné s jedním jazykovým modelem.
LLM není mozek
Dnešní debata o AI často zaměňuje jednu mimořádně schopnou komponentu za celý inteligentní systém. LLM pracuje s naučenými statistickými vztahy a vytváří pravděpodobnostní pokračování podle zadání a kontextu. Umí jazyk, asociace, generalizaci a řešení mnoha problémů. To z něj ale ještě nedělá celý „mozek“.
Kdybychom použili biologickou analogii, LLM připomíná spíše mimořádně výkonnou jazykovou a asociační část. Samostatně v něm nemusí existovat trvalá autobiografická paměť, stabilní identita, specializovaný matematický mechanismus, dlouhodobá zkušenost, systém oprávnění ani vrstva, která rozhoduje, co z pravděpodobného návrhu skutečně platí.
To neznamená, že LLM není inteligentní v žádném smyslu. Jeho schopnosti mohou být překvapivě široké. Znamená to jen, že od jedné komponenty požadujeme práci celého systému:
- rozumět jazyku,
- počítat,
- uchovávat osobní a provozní historii,
- rozhodovat o oprávněních,
- plánovat,
- ověřovat fakta,
- poznat vlastní nejistotu,
- poučit se z výsledku a zachovat zkušenost do budoucna.
Problém tedy možná není v tom, že máme málo inteligentní LLM. Možná po jedné části systému chceme, aby zastala práci celého mozku.
Co LLM skutečně dělá
LLM přijímá posloupnost tokenů, pracuje s naučenými reprezentacemi a generuje další tokeny podle pravděpodobnostního rozložení. Tato věta zní technicky, ale má praktický dopad: výstup modelu je návrh, nikoli automaticky ověřená skutečnost.
LLM může být výborné v tom, že:
- převede nejasný lidský záměr do struktury,
- najde podobnosti mezi situacemi,
- navrhne několik možností,
- vysvětlí složitou věc různým typům čtenářů,
- shrne velké množství textu,
- připraví první verzi postupu, kódu nebo dokumentu.
U důležitých rozhodnutí ale potřebuje spolupracovat s dalšími vrstvami. Kalkulaci je vhodné svěřit matematickému enginu, stav zákazníka načíst ze strukturované databáze, oprávnění ověřit policy vrstvou a nevratnou operaci provést pouze přes přesně definovanou capability.
Jazykový model tak není zmenšený člověk uvnitř počítače. Je to velmi silná specializovaná komponenta, která může zprostředkovat práci s jazykem, kontextem a novými hypotézami.
Agent není automaticky inteligentnější systém
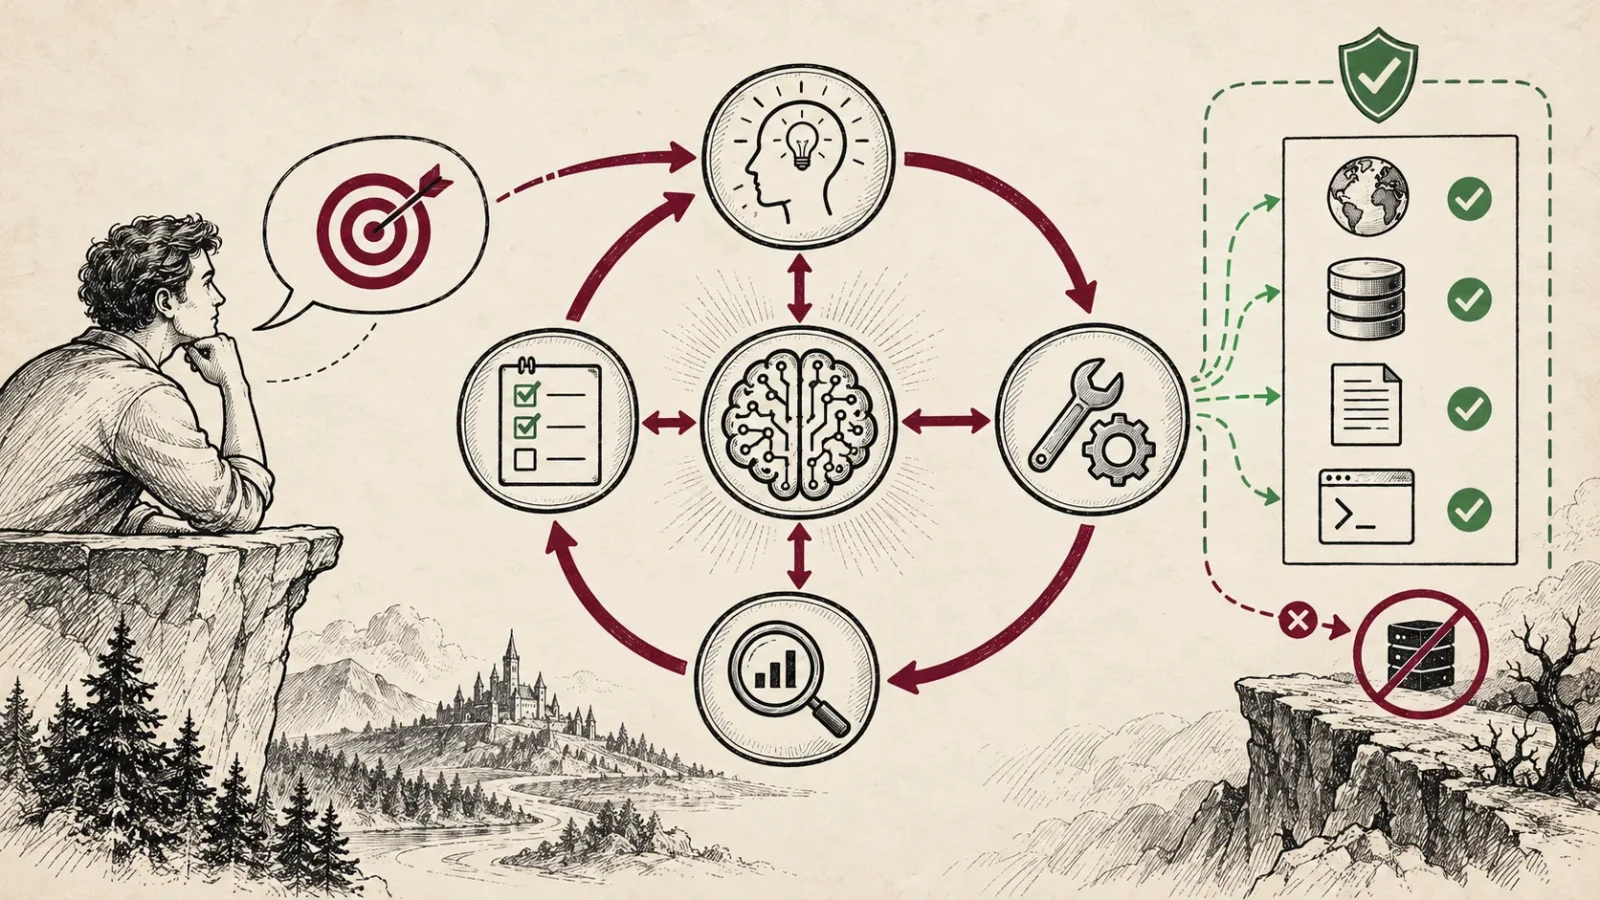
Agent přidává k modelu plánování, nástroje, stav běhu a opakování. Člověk zadá cíl, model navrhne další krok, orchestrátor zavolá nástroj, systém načte výsledek a model rozhodne, zda pokračovat.
Autonomie zde znamená: „Dokáže systém pokračovat bez dalšího zásahu člověka?“
To je důležitá vlastnost, ale není to celá inteligence. Autonomní agent nemusí mít:
- trvalou autobiografickou paměť,
- stabilní identitu napříč jednotlivými běhy,
- ověřený mechanismus učení,
- schopnost rozlišit pravidlo od hypotézy,
- vlastní systém odpovědnosti,
- jasnou představu o tom, co skutečně ví.
Agent může být velmi autonomní a přitom pouze opakovat pravděpodobnostní rozhodovací smyčku. To je užitečné. Není to ale automatický důkaz, že vznikl širší inteligentní systém.
Když pravděpodobnostní model dostane volant
U běžného chatbota se chyba často projeví jako nepřesná nebo nesmyslná věta. U agenta se stejná chyba může změnit v operaci:
- úpravu nesprávného zákaznického záznamu,
- odeslání zprávy nesprávnému příjemci,
- objednávku služby nebo zboží,
- změnu konfigurace,
- zveřejnění citlivého obsahu,
- spuštění nákladného nebo nevratného procesu.
Proto kolem agentů vznikají oprávnění, sandboxy, schvalování, limity, guardrails, filtrování a auditní záznamy. OpenAI mezi stavební prvky agentních systémů uvádí nástroje, handoffs, bezpečnostní kontroly a trasování běhu. Anthropic zase rozlišuje předem dané workflow od agentních systémů, které dynamicky řídí vlastní postup.
Tyto vrstvy dávají smysl. Zároveň ale mohou vést k architektonické zkratce: postavíme jazykový model do středu, dáme mu široké nástroje a potom kolem něj přidáváme stále vyšší zábrany.
Harness omezuje model. Self mění architekturu
Pro řídicí konstrukci kolem modelu používám slovo harness. Model je hlavní rozhodovací jednotkou a systém se snaží omezit, co smí udělat.
Harness řeší otázku:
Jak bezpečně omezit model, který plánuje a jedná?
Self řeší jinou otázku:
Proč by jeden pravděpodobnostní model měl být řídící jednotkou systému vůbec?
To neznamená, že harness je špatně. U otevřených, vratných nebo nízkorizikových úkolů může být agentní architektura přesně to, co potřebujeme. Pokud ale stavíme dlouhodobý systém s identitou, zkušeností a odpovědností, nestačí jen bezpečně obalit jeden model dalšími vrstvami.
LLM není řidič ani střed systému
Self nevzniká tak, že vezmeme LLM a postavíme kolem něj paměť, policy a několik nástrojů. LLM je pouze jedna jeho komponenta — podobně jako paměť, matematický engine, jazykový parser, znalostní vrstva, procedury nebo capabilities.
V některých situacích může být nejdůležitější částí. V jiných se vůbec nemusí spustit. Model systém nikdy neřídil sám o sobě; řídící roli mu přiděluje konkrétní architektura.
Jazyková vrstva může například:
- pochopit, že věta „přesuň schůzku na příští týden“ odkazuje na konkrétní událost,
- navrhnout strukturu požadavku,
- upozornit na nejasnost,
- vytvořit vysvětlení pro člověka.
Context vrstva může určit, kterého zákazníka a projektu se požadavek týká. Policy ověří oprávnění. Kalendářní engine zkontroluje kolizi. Capability provede změnu a historie zapíše výsledek. LLM pomohl převést jazyk do návrhu, ale systém jako celek rozhodl, co se smí skutečně stát.
Digitální mysl se skládá z více specializovaných částí
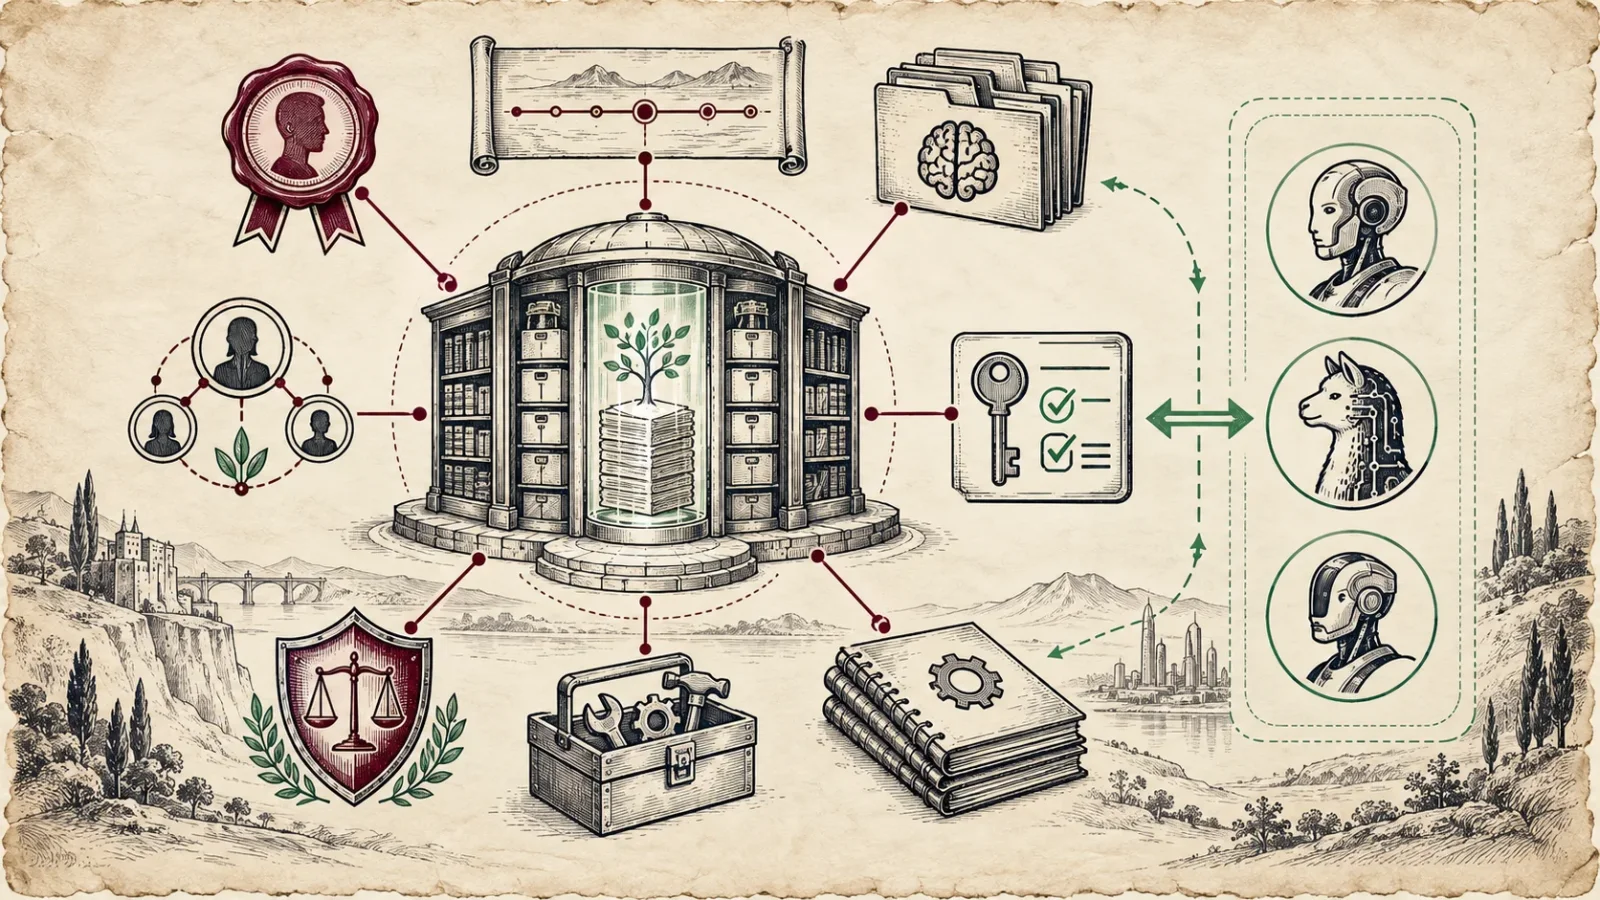
Pokud nechceme zaměnit LLM za celý mozek, musíme přemýšlet o širší pracovní architektuře. Uprostřed nemusí být jeden model, ale například cognitive / decision workspace, který propojuje specializované mechanismy.
Takový systém může obsahovat:
- Language Engine: práce s přirozeným jazykem a významem,
- Memory: strukturované vzpomínky, fakta a preference,
- Context: určení situace, účastníků a relevantního stavu,
- Math Engine: přesné výpočty, rozpočty a validace čísel,
- Knowledge: ověřené zdroje, dokumenty a vztahy mezi nimi,
- Procedures: schválené postupy pro opakované situace,
- Capabilities: přesně vymezené operace, které lze vykonat,
- Policy: pravidla oprávnění, rizik a lidského schválení,
- Metacognition: odhad nejistoty, kontrola vlastního postupu a rozhodnutí, kdy se zeptat,
- Identity: účel, hranice, vztah k lidem a odpovědnost systému,
- Learning: proces, který převádí ověřenou zkušenost do znalosti nebo procedury.
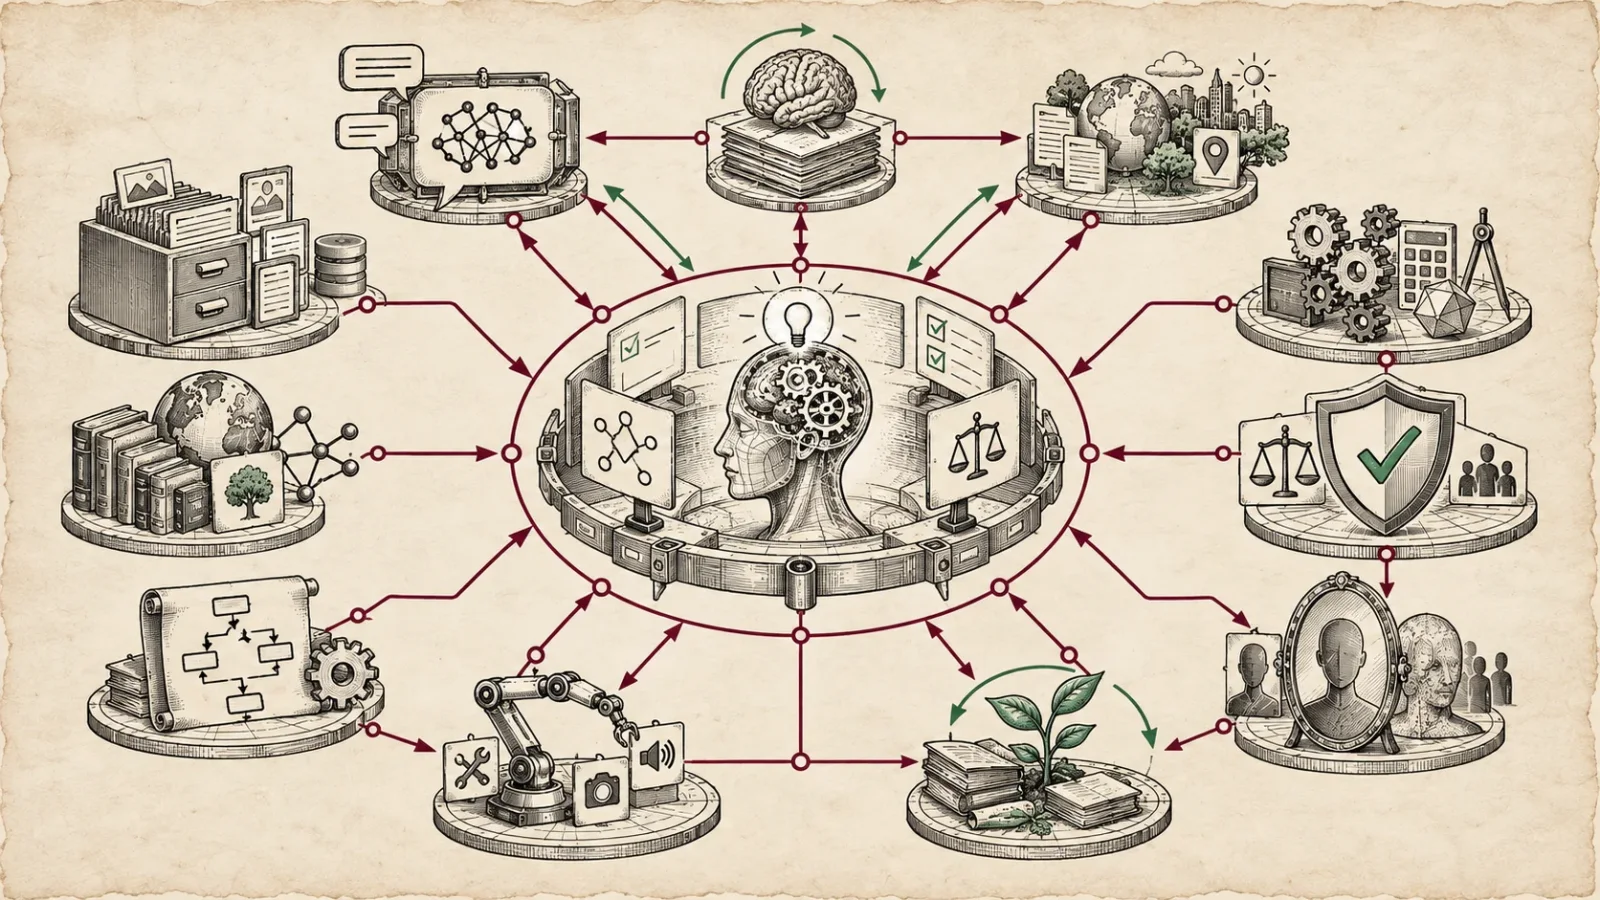
Smyslem není kopírovat biologický mozek do softwaru. Smyslem je rozdělit odpovědnosti tak, aby jazykový model nemusel být současně databází, kalkulačkou, bezpečnostní bránou, archivem i rozhodovacím orgánem.
Paměť není historie a historie není zkušenost
V AI systémech se slovem paměť označuje několik různých věcí. Uložená konverzace je záznam. Vektorová databáze je index pro vyhledání podobného obsahu. Log běhu popisuje události. Ani jedno samo o sobě ještě není zkušenost.
Pro dlouhodobý systém je užitečné rozlišovat alespoň:
- data: co se stalo nebo co někdo uvedl,
- historii: kdy, v jakém kontextu a s jakým výsledkem se událost stala,
- znalost: ověřené tvrzení, které lze znovu použít,
- pravidlo: podmínka, podle které se má systém zachovat,
- proceduru: sled kroků pro opakovanou situaci,
- hypotézu: návrh, který ještě nebyl potvrzen.
Bez tohoto rozlišení může systém uložit i omyl a příště s ním zacházet jako s pravidlem. Self proto nepotřebuje jen větší paměť. Potřebuje také způsob, jak zkušenost ověřit, označit její platnost a rozhodnout, zda se smí stát součástí dalšího jednání.
Jak se pravděpodobnostní řešení mění v naučenou schopnost
Jedna z nejsilnějších myšlenek celé architektury je tato:
LLM může pomoci zkušenost objevit. Self ji může proměnit v ověřenou schopnost.
LLM problém pokaždé znovu řeší. Self může výsledek převést na znalost, pravidlo, proceduru nebo capability. Pravděpodobnostní řešení se zkušeností může měnit v deterministickou schopnost.
Příklad:
- Systém dostane požadavek na servis zařízení.
- LLM pomůže rozpoznat typ požadavku a navrhne postup.
- Člověk nebo policy vrstva zkontroluje, zda je postup správný.
- Systém ověří typ zařízení, záruční stav a dostupnost technika.
- Založí servisní zakázku, rezervuje termín a odešle potvrzení.
- Po několika ověřených opakováních se tento postup uloží jako procedura.
Při příštím stejném požadavku už není nutné nechat model volně vymýšlet každý krok. LLM může rozpoznat výjimku nebo nejasnost, ale běžná cesta proběhne přes testovatelnou proceduru a úzké capabilities.
Proč Self může postupně potřebovat méně LLM
Současný vývoj často směřuje k tomu, že stále více úkolů posíláme do větších modelů. U Selfu může fungovat opačný proces.
Na začátku systém často potřebuje LLM pro interpretaci nejasného zadání, hledání možných řešení, vysvětlení situace a návrh nového postupu. Postupně ale mohou vznikat strukturované znalosti, ověřené procedury, pravidla, kontrolní body a jasné podmínky, kdy se musí zapojit člověk.
Známý problém už potom nemusí být generován. Systém ho vyřeší způsobem, který lze testovat, auditovat a opakovat. Dobře navržený Self proto nemusí s učením potřebovat stále větší model. U známých problémů může generativní model potřebovat stále méně. Jeho role se přesune k novým, nejasným, kreativním nebo jazykově náročným situacím.
Self může fungovat i bez LLM
Věta, že Self může používat několik modelů nebo žádný, může znít paradoxně. Jak může být systém umělé inteligence bez AI?
Self bez LLM nezmizí. Stále může znát svou identitu a aktuální stav, číst strukturovanou paměť a historii, provádět naučené procedury, počítat pomocí Math Engine, reagovat na události, používat deterministické capabilities a vyžádat si člověka, když se objeví neznámá situace.
Pouze přijde o jednu schopnost: flexibilní generativní práci s jazykem a novými situacemi. Podobně jako člověk může fungovat i bez právě probíhajícího vnitřního monologu, systém může udržovat svou kontinuitu a provádět známé operace bez jazykového modelu.
Model je vyměnitelná část. Pokud se vymění LLM, nemusí se vyměnit identita, historie, policy, procedury ani oprávnění Selfu.
Capabilities nejsou obecný přístup k nástrojům
Bezpečnostní rozdíl mezi obecným nástrojem a capability je zásadní. Obecný nástroj může být přímý přístup k databázi, shellu nebo produkční konfiguraci. Capability je přesně definovaná a omezená operace.
Namísto oprávnění „uprav databázi“ může systém nabídnout capability:
customer.address.update
Ta určí, který záznam lze změnit, jaké pole je možné upravit, jaký formát musí mít nová hodnota, kdo smí operaci požadovat, zda je nutné potvrzení člověka, co se zapíše do auditní historie a zda je možné změnu vrátit.
LLM může navrhnout: „Uživatel pravděpodobně požaduje změnu adresy zákazníka.“ Deterministická část systému ověří identitu, oprávnění, formát a pravidla. Pokud něco nesedí, změna se neprovede, i kdyby model pokračoval v přesvědčivém vysvětlování.
Od programu k digitální entitě
„Entita“ zde neznamená vědomou bytost. Znamená systém, u kterého můžeme určit, že jde napříč časem stále o tentýž systém.
Takový systém má identitu a účel, historii událostí a rozhodnutí, strukturovanou paměť, vztahy k lidem a projektům, specializované schopnosti, pravidla pro své jednání, mechanismus učení a možnost pokračovat po restartu, výměně zařízení nebo modelu.
Model můžeme vyměnit. Počítač můžeme vyměnit. Self přesto pokračuje, protože jeho kontinuita neleží v jediném výstupu jazykového modelu.
Co se mění v bezpečnostním návrhu
U agentního systému se často ptáme: Jak zabráníme modelu, aby provedl něco, co nemá?
U architektury založené na Self se ptáme ještě dříve: Proč by měl mít model možnost tuto operaci provést přímo?
Praktické principy mohou být například:
- LLM nezná produkční přihlašovací údaje,
- každá capability má minimální rozsah oprávnění,
- nevratné a finanční operace vyžadují potvrzení člověka,
- všechny změny mají auditní stopu,
- policy vrstva je oddělená od textového návrhu modelu,
- historie rozlišuje návrh, schválení, provedení a výsledek,
- známé procedury se testují bez jazykového modelu,
- výpadek modelu neznamená ztrátu identity nebo dat systému.
NIST ve svém profilu pro generativní AI zdůrazňuje, že rizika mohou vznikat v různých fázích životního cyklu a na úrovni modelu, konkrétní aplikace i širšího systému. Nestačí proto testovat pouze odpovědi modelu. Je potřeba testovat také nástroje, oprávnění, datové toky, provozní kontext, obnovu po chybě a způsob lidského dohledu.
Jak poznat, že stavíte agenta, nebo už základ Self
Rozdíl není v marketingovém názvu. Položte si několik návrhových otázek:
- Existuje systémová identita oddělená od aktuálního modelu?
- Dokáže systém navázat na předchozí stav po restartu?
- Je paměť strukturovaná, nebo jen připojený text?
- Umí systém rozlišit zkušenost, pravidlo, hypotézu a domněnku?
- Jsou schválené postupy vykonávané deterministicky?
- Má každá důležitá schopnost přesné hranice a auditní záznam?
- Umí systém říct, že potřebuje člověka?
- Lze vyměnit jazykový model bez ztráty identity a historie?
- Existuje proces, kterým se nové zkušenosti ověřují před uložením?
Pokud většina odpovědí zní ne, pravděpodobně stavíte užitečného agenta nebo workflow. To není problém. Je to přesnější popis. Ne každý úkol potřebuje Self a ne každý agent musí být dlouhodobá entita.
LLM odpovídá. Agent vykonává. Self přetrvává.
Pro účely tohoto článku budeme za širší inteligentní systém považovat systém, který kromě generování dokáže pracovat s pamětí, zkušeností, nejistotou, specializovanými schopnostmi a kontinuitou v čase. Není to obecná vědecká definice inteligence. Je to pracovní definice architektury, kterou se snažíme popsat.
LLM odpovídá. Pomáhá pracovat s jazykem, asociacemi, vysvětlením a novými hypotézami.
Agent vykonává. Zapojuje model do smyčky, která vybírá kroky, používá nástroje a reaguje na pozorování.
Self přetrvává. Drží identitu, historii, paměť, vztahy, procedury, capabilities, oprávnění a kontinuitu, i když se model nebo konkrétní agent vymění.
Co když skutečnou AI teprve skládáme?
Možná se příliš soustředíme na otázku, jak vytvořit model, který dokáže všechno: psát, počítat, plánovat, pamatovat si, vyhledávat, ovládat počítač a řídit další modely.
Jiná otázka může být praktičtější:
Jak postavit digitální systém, ve kterém má každý druh inteligence své správné místo?
V takovém systému může být LLM fantastická jazyková a objevovací vrstva. Agent může být účinný mechanismus pro provedení časově omezeného cíle. Deterministické capabilities mohou chránit data a peníze. Procedury mohou uchovat zkušenost. Historie může zajistit kontinuitu. Člověk může zůstat rozhodujícím partnerem u situací, které vyžadují odpovědnost, hodnotový úsudek nebo vztah.
Další krok AI tedy nemusí být jen superagent s více nástroji a delším během. Může jím být systém, který odděluje návrh od rozhodnutí, rozhodnutí od oprávnění a oprávnění od provedení.
Možná právě tam začíná rozdíl mezi procesem, který autonomně vykoná úkol, a digitální entitou, která si v čase zachová kontinuitu.
Krátké shrnutí
- LLM je silná specializovaná komponenta, ne celý inteligentní systém.
- Agent je autonomní mechanismus pro řešení cíle, ne automaticky stabilní inteligence.
- Harness omezuje model, zatímco Self mění rozložení odpovědností v celé architektuře.
- Self může skládat jazyk, paměť, kontext, matematiku, znalosti, procedury, policy, capabilities, identitu a učení.
- LLM může pomoci zkušenost objevit, ale Self ji může proměnit v ověřenou schopnost.
- Čím více známých problémů se převede na procedury, tím méně musí systém spoléhat na generativní odhad.
- Self může fungovat i bez LLM, protože model je pouze jedna z jeho schopností.
Zdroje a další čtení
- ReAct: Synergizing Reasoning and Acting in Language Models – výzkumný článek o propojení uvažování, akcí a pozorování v interaktivním řešení úloh.
- OpenAI: New tools for building agents – nástroje, handoffs, guardrails a trasování agentních workflow.
- Anthropic: Building Effective AI Agents – rozlišení workflow, single-agent a multi-agent architektur.
- NIST: Artificial Intelligence Risk Management Framework: Generative AI Profile – rizika generativní AI v kontextu návrhu, nasazení a životního cyklu systému.
- NIST AI RMF Playbook – praktické oblasti řízení rizik: govern, map, measure a manage.